ローカルLLMの実行環境を見直しました。もともと使っていたのは、2026年7月頃に導入したQwen3.6-35B-A3Bです。
Qwen3.8が出た2026年8月頃に見たときは、パッと見では50トークン/秒程度しか出なさそうでした。今使っているQwen3.6-35B-A3Bは200トークン/秒超なので、4分の1程度の速度になってしまいます。これでは置き換えにならないと感じ、いったん見送っていました。
ただ、その後調べ直すと、設定をきちんとすればよい環境では100トークン/秒程度まで出ることもあるようでした。速度の振れ幅も大きそうで、一概に遅いと片付けるのは早いと思い直しました。最近、Qwen3.8-Flash-NextがゲーミングPCで動くようになったというPC Watchの記事(https://pc.watch.impress.co.jp/docs/news/2145142.html、2026-10-02)を見かけたこともあり、実際に試して確かめ、置き換えるかどうかを判断することにしました。
結論から言うと、コーディングエージェント用途ではQwen3.8-Flash-Nextがよいと考えています。対話型エージェントのように、長いやり取りを最初から前提としない用途では、負荷もGPUだけで完結するQwen3.8-27Bあたりがよい、というところに落ち着きました。ここからは、この結論に至るまでに取り組んだ内容を書いていきます。
前提
実行環境
| 項目 | 内容 |
|---|---|
| CPU | AMD Ryzen 9 9950X |
| GPU | NVIDIA GeForce RTX 5070 Ti(VRAM 16GB、PCIe 5接続、ドライバー 610.88) |
| RAM | 64GB(DDR5-6000運用) |
| OS | Windows 11 |
| ストレージ | 内蔵NVMe SSD 2TB(Gen4) |
測定は単一マシンで行いました。CPUとGPUは電力に上限を設け、既定より抑えた設定で運用しています。標準設定で測ったものではないため、厳密には参考値になります。
エンジンとバージョン
| 実行環境 | バージョン | 公開日 |
|---|---|---|
| Ollama | 0.35.1 | 2026-09-29 |
| llama.cpp | 0.5.0-dev(build 11146) | 2026-09-23 |
| Strata | 0.1.38 | 2026-10-03 |
Strata(https://github.com/Niko1221/Strata)は、llama.cppの一部を利用して作られており、llama.cppと並ぶ独立した実行基盤ではありません。3構成は同時に常駐させず、1環境ずつ排他的に実行しました。切り替えは停止、VRAM解放の確認、起動の順で行っています。
この切り替えの仕組みは、今回の測定のためだけではなく、普段使いを目的としています。起動と停止をまとめたスクリプトを自作し、普段の利用でも3構成を切り替えられるようにしました。
使ったモデル
| 使ったモデル(量子化) | BenchLM順位 | Hugging Face(https://huggingface.co/) |
|---|---|---|
| Qwen3.8-Flash-Next(Swift 1.5, IQ2_XS) | 39位 | ukisai/Swift-1.5-Qwen3.8-Flash-Next-GSQ-RCO-GGUF |
| Qwen3.8-27B(IQ3_XXS, MTP) | 56位 | byteshape/Qwen3.8-27B-GGUF |
| Qwen3.6-35B-A3B(APEX-MINI) | 115位 | mudler/Qwen3.6-35B-A3B-APEX-MTP-GGUF |
順位はBenchLM(https://benchlm.ai/models、2026-10-04時点)が量子化前のモデルを対象につけた総合スコアによるものです。ローカルLLMに限らず、クラウドのフロンティアモデルも含む全783モデルのうち、順位づけされている212モデルの中での順位です。公開ベンチマークを横断した指標のため、参考として掲載しています。
比べた3構成
今回は次の3構成を比べました。Qwen3.8-Flash-NextとQwen3.8-27Bは今回あらためて選び直したもので、Qwen3.6-35B-A3B(APEX-MINI)は補足として加えています。
| モデル | 量子化 | 実行環境 |
|---|---|---|
| Qwen3.8-Flash-Next | IQ2_XS, Swift 1.5 | Strata |
| Qwen3.8-27B | IQ3_XXS, MTP | llama.cpp |
| Qwen3.6-35B-A3B | APEX-MINI | Ollama |
Qwen3.8-Flash-Nextは、当初はISTA-DASLabが公開したQ2_0を使いました。Strataが扱う圧縮サイズの中で容量が最も小さく、メモリを圧迫しにくいためです。ただ実際に使ってみたところ、一部に中国語が紛れるケースがたびたび確認されたため、常用するには不安が残り、量子化を一段上のIQ2_XSに上げています。同じIQ2_XSで比べたとき、派生のSwift 1.5の方が処理が速いのではと見込み、これを採用しました。
Qwen3.8-27Bは、配布元byteshapeのIQ3_XXSを選びました。IQ3の中では容量が小さい方で、その分をコンテキスト長に回せると考えたためです。コンテキスト長が狭いと用途が限られ、画像入力を併用する余地も小さくなります。IQ3の水準を確保しつつ、容量を抑えたものを選んだという判断です。
Qwen3.6-35B-A3Bは、以前から使っていた構成です。設定をよく分かっていない時期に作ったため、最適な設定とは言い切れません。横並びで比べる場合は、その分不利になる可能性が高いです。その前提のうえで、参考として載せています。なお、APEX-MINIは、層ごとに精度を変える混合量子化です。おおよそQ2相当からQ5相当で、中間層のexpertがQ2相当、edge層がQ3相当、共有expertがQ4〜Q5相当になります。詳しくはモデルの公開元をご確認ください。
この環境で使用するために調整した値
主な設定は次のとおりです。これ以外の起動フラグや環境変数は、末尾の付録にまとめました。
| 設定項目 | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.6-35B-A3B |
|---|---|---|---|
| コンテキスト長 | 262K(--max-context) | 131K(ctx-size) | 65K(num_ctx) |
| KVキャッシュ | int8(--kv) | q4_0(cache-type-k / cache-type-v) | q4_0(OLLAMA_KV_CACHE_TYPE) |
| speculative decoding | --spec 4 / --spec-min-p 0.7 / MTP(--mtp) | draft-mtp / spec-draft-n-max 2(MTPヘッド内蔵) | draft_num_predict 2(MTPヘッド) |
| temperature | 0.6 | 0.6 | 0.6 |
方法
測定の観点
同じマシン上で3構成を動かし、相対的な違いを見ます。モデルの賢さを測るものではなく、この環境で使ううえで何がどう違うかを知るためのもので、観点は速度・応答性、品質、リソースの3つです。試行回数も少ないため、結果は目安として扱ってください。
| 観点 | 指標 | 測定の意図 |
|---|---|---|
| 1. 速度・応答性 | トークン処理速度、1リクエストあたりの所要時間、入力処理速度、長い入力の読み込み速度、TTFT | 生成の速さと、実際に待つ時間を見るため |
| 2. 品質 | 正答数、1問あたりの平均出力トークン数、1問あたりの平均所要時間、42問合計の所要時間 | 正しく解けるかと、そのときの生成の長さ、待ち時間を見るため |
| 3. リソース | VRAM使用量、GPU利用率、電力、RAM使用量 | 同じ単一マシンで動かし続けるときの負荷を見るため |
テストの内容
いずれも今回の比較用に用意した問題セットです。
| テスト | 問題数 | 内訳 | 試行 |
|---|---|---|---|
| 速度テスト | 3プロンプト | 短文生成・要約・検算 | 2回 |
| 品質テスト | 21問 | 7種類を3問ずつ | 各2回(合計42回分) |
長い入力の読み込み速度も別途測りました。問題の詳細は付録にまとめました。
測定の条件
生成の上限は、速度テストが最大256トークン、品質テストが最大2,048トークンです。各実行環境を1回起動し、その中で試験を2回続けて実行し、seedは1回目が2026、2回目が2027でした。最初の読み込みは速度指標から除き、速度テストは生成中のトークンを順次受け取り、品質テストは生成後に応答をまとめて受け取りました。
結果
比べた結果、短い生成ではQwen3.6-35B-A3Bが最も速く、1問を解き切る長い生成ではQwen3.8-Flash-Nextが最も短い時間でした。正答数は3構成ともほぼ同じで、用途によって優劣が入れ替わります。ここから、コーディングエージェント用途にはQwen3.8-Flash-Nextを、対話型エージェント用途にはQwen3.8-27Bを選んでいます。
測定は2回行いました。各表には対象と集計方法を添え、速さの指標には有利な向きも書いています。以降、速度・応答性、品質、リソースの順に見ていきます。
1. 速度・応答性
速度テスト
対象は速度テスト3プロンプトです。集計方法は2回分の平均です。


表1 速度テストの数値
| 指標(単位) | Qwen3.8-Flash-Next(IQ2_XS) | Qwen3.8-27B(IQ3_XXS) | Qwen3.6-35B-A3B(APEX-MINI) |
|---|---|---|---|
| 速度テストの1リクエストあたりの所要時間(秒) | 2.52 | 2.60 | 1.20 |
| トークン処理速度(トークン/秒) | 89.31 | 89.68 | 237.18 |
| 1リクエストあたりの出力トークン数(個) | 167.5 | 213.5 | 256 |
所要時間は小さいほど速く、トークン処理速度は大きいほど速い指標です。出力トークン数は生成の長さを表す指標で、所要時間は出力トークン数を含むため、あわせて読みます。
入力処理と初回トークンまでの時間(TTFT)
長い入力の読み込み速度では、約3,000トークンの入力(約3022〜3066トークン。モデルごとにトークナイザが異なるため幅がある)を対象としました。入力処理速度の対象は、速度テスト3プロンプトに付随する入力です。集計方法は2回分の平均です。
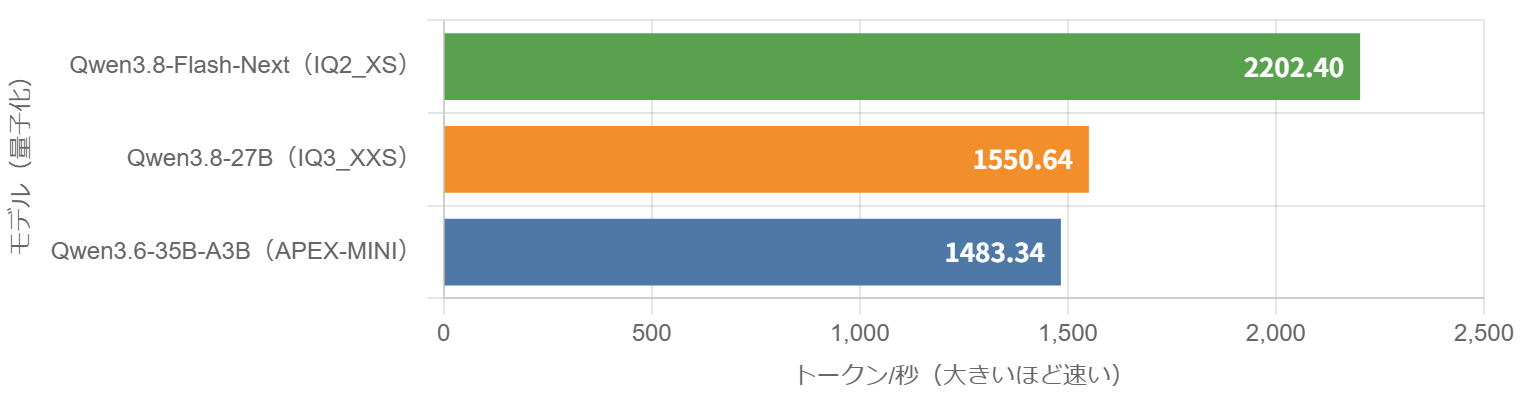
表2 入力処理の数値
| 指標(単位) | Qwen3.8-Flash-Next(IQ2_XS) | Qwen3.8-27B(IQ3_XXS) | Qwen3.6-35B-A3B(APEX-MINI) |
|---|---|---|---|
| 長い入力の読み込み速度(トークン/秒) | 2202.40 | 1550.64 | 1483.34 |
| 初回トークンまでの時間(TTFT)(秒) | 0.59 | 0.26 | 0.11 |
| 入力処理速度(トークン/秒) | 288.80 | 693.53 | 1011.82 |
長い入力の読み込み速度と入力処理速度は大きいほど速く、TTFTは小さいほど速くなります。
2. 品質
対象は品質テスト21問で、各問を2回解かせた42回分です。正答数と42問合計の所要時間は合計、1問あたりの出力トークン数と所要時間は平均で集計しました。
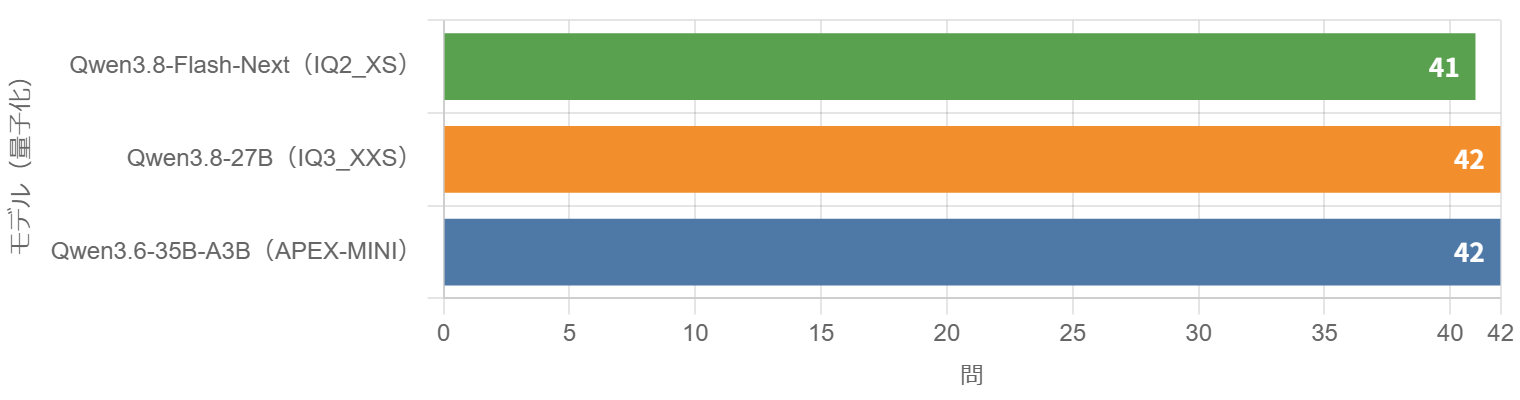
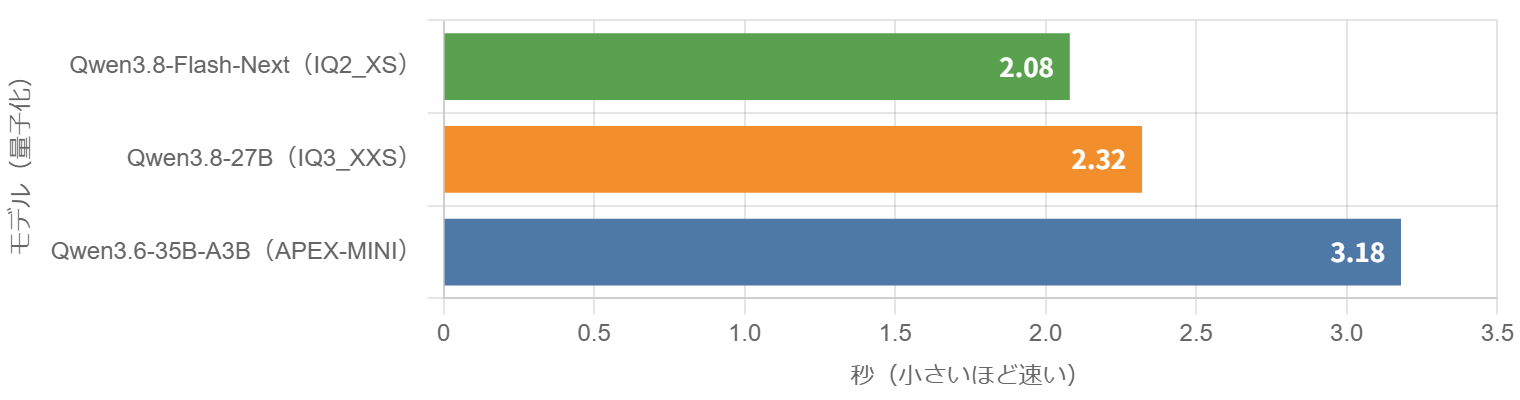
表3 品質テストの数値
| 指標(単位) | Qwen3.8-Flash-Next(IQ2_XS) | Qwen3.8-27B(IQ3_XXS) | Qwen3.6-35B-A3B(APEX-MINI) |
|---|---|---|---|
| 正答数(/42問) | 41 | 42 | 42 |
| 品質テストの1問あたりの平均所要時間(秒) | 2.08 | 2.32 | 3.18 |
| 1問あたりの平均出力トークン数(個) | 144.6 | 186.5 | 815.1 |
| 42問合計の所要時間(秒) | 87.2 | 97.3 | 133.4 |
1問あたりの平均所要時間は小さいほど速いです。Qwen3.8-Flash-Nextの誤答は、条件に合う件数を数える問題(複合条件集計)の1問のみでした。1回目は不正解で、2回目は正解です。ほかの2構成は21問すべて正解でした。
3. リソース
対象は計測中の1秒サンプリングです。集計方法は2回分の平均です。
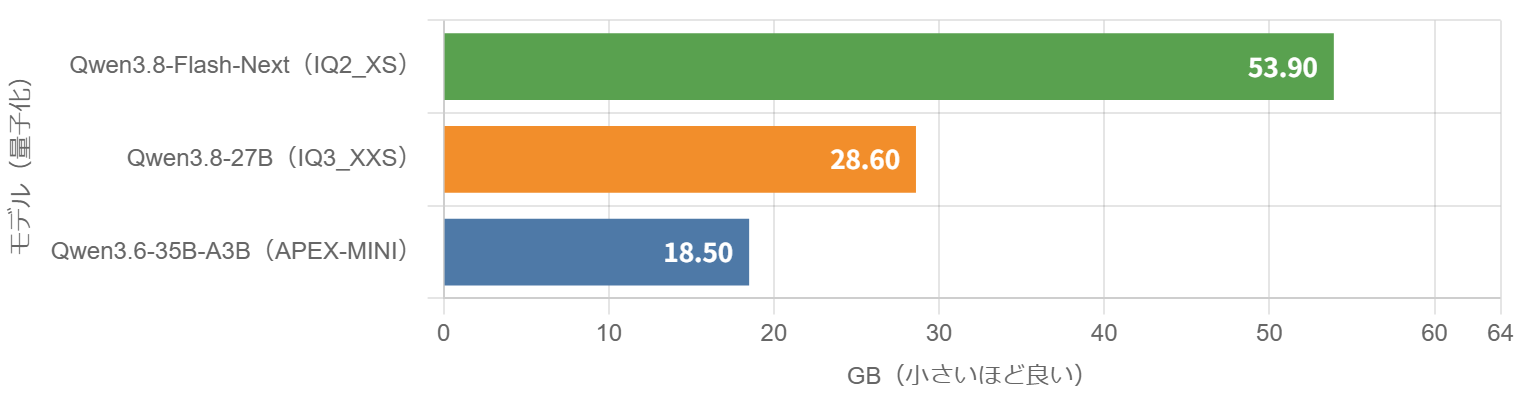
表4 リソースの数値
| 指標(単位) | Qwen3.8-Flash-Next(IQ2_XS) | Qwen3.8-27B(IQ3_XXS) | Qwen3.6-35B-A3B(APEX-MINI) |
|---|---|---|---|
| RAM使用量(GB) | 53.9(84.2%) | 28.6(44.6%) | 18.5(28.9%) |
| VRAM使用量(GB) | 14.0(87.5%) | 14.2(89.0%) | 14.5(90.8%) |
| GPU利用率(%) | 93.7 | 83.2 | 79.7 |
| GPU電力(W, 参考値) | 128.9 | 224.9 | 183.0 |
2回分の標本数はQwen3.8-Flash-Nextが81、Qwen3.8-27Bが101、Qwen3.6-35B-A3Bが122でした。VRAMとRAMの使用量は、モデル単体ではなく、モデルを起動しているときのPC全体(OSや他プロセスを含む)の値です。割合は、それぞれ16GBと64GBに対するものです。GPU電力は、1秒サンプリングで得たnvidia-smiのpower.draw(瞬間値)の平均であり、参考値として扱います。RTX 5070 Tiの上限は300Wです。RAM使用量は、モデルをロードしていないアイドル状態でも約12.3GBで、表の値にはこの分も含まれます。そのため、表の値がすべてモデルの使用量というわけではありません。
考察
所要時間の指標は、速度テストの1リクエストあたりの所要時間と、品質テストの1問あたりの平均所要時間の2つです。この2つでは順位が逆になりました。
速度テストでは、1リクエストあたりの所要時間がQwen3.6-35B-A3Bで最も短く、Qwen3.8-Flash-NextとQwen3.8-27Bは同程度でした。トークン処理速度もQwen3.6-35B-A3Bが最も速く、Qwen3.8系の2つは同程度です。Qwen3.8-Flash-Nextは、プロンプトによって76〜92トークン/秒の範囲でした。
品質テストでは順序が逆になり、1問あたりの平均所要時間はQwen3.8-Flash-Nextが最も短く、Qwen3.6-35B-A3Bが最も長い結果でした。正答数は3構成ともほぼ同じで、42問中41〜42問です。
この逆転は、1問あたりの生成トークン数が構成ごとに違うためです。Qwen3.6-35B-A3Bは1問あたり815.1個を生成しました。これはQwen3.8-Flash-Nextの144.6個、Qwen3.8-27Bの186.5個の4〜5倍です。生成が速くても書く量が多ければ所要時間は延びます。短い応答で比べるとQwen3.6-35B-A3Bが速く、1問を解き切るような長い生成ではQwen3.8-Flash-Nextの待ち時間が短い、という違いになります。
リソースでは、RAM使用量がQwen3.6-35B-A3Bで約18.5GB、Qwen3.8-27Bで約28.6GB、Qwen3.8-Flash-Nextで約53.9GBでした。Qwen3.8-Flash-Nextは125B規模のモデルで、モデルの一部がRAM上に展開されるため、この構成ではRAMの大部分を占めていました。
まとめ
この比較は、もともとローカルLLMの実行環境を見直すために始めたものです。ただ、エージェント用途というほどの目線の試験だったかというと、心もとないところがあります。今回確かめたのは、コンテキストに余裕がある状態での振る舞いまでです。ひとまず、ここまでの内容から得られた情報をまとめていきます。
コーディングエージェント用途:Qwen3.8-Flash-Next
私の環境では、VS Codeの拡張機能としてコーディングエージェントを使い、複数のMCPを組み合わせています。MCPの分だけ、やり取りに必要なトークン数が増えます。Qwen3.6-35B-A3Bは1回のやり取りで使うトークン数も多く、コンテキスト長は65Kまででした。そのため、以前試したところ、初回の実行で弾かれてしまい、コーディングエージェント用途では使えませんでした。割り当てていたMCPが多かったことが原因かもしれません。Hermes Agentのような対話型エージェントでの利用にとどまっていました。
Qwen3.8-Flash-Nextは262Kまで使えるようになっています。実際に使ってみると、問題なく動きました。パソコンのドライブ内の情報をHTMLで整理して視覚的に表示する使い方も試しましたが、こちらも表示できました。コーディングでも使えるようになり、置き換えというより、ローカルLLMの新しいポジションになったと感じています。
今回の品質テストでは、Qwen3.8-Flash-Nextの1問あたりの生成トークン数が3構成の中で最も少なく、所要時間も最短でした。コンテキスト長の余裕と合わせて、やり取りが長くなるほど他の2構成より有利になります。長く使う場面では、Qwen3.8-Flash-Nextが向いていると考えます。
対話型エージェント用途:Qwen3.8-27B
ただし、Qwen3.8-Flash-Nextがすべての用途で最適というわけではありません。125Bのモデルでメモリの空きが10GB程度になるため、長いコンテキストや賢さを求めない対話型エージェント用途では、VRAM上の展開のみでも動くQwen3.8-27Bの方が適します。
Qwen3.8-27Bは、品質テストの1問あたりの所要時間がQwen3.6-35B-A3Bより短く、生成トークン数も少ない結果でした。私の使い方としては、単発の速さを競うより、1つのスレッド内でやり取りを重ねることが多くなります。スレッドが長引くほど、生成トークン数が少ない方が効いてきます。
ドライブ内の重複ファイルや空フォルダ・空ファイルの探索などは、Pi(Coding Agent)のような軽量エージェントでこなせる用途です。試したところ、問題なく動きました。コンテキスト長131Kも使えます。バランスがよいところに落ち着きました。
今回の気づき
今回の環境見直しで、1回のやり取りに必要なトークン数の影響を実感しました。必要量が少なければ、トークン処理速度が高くなくても待ち時間はそれほど延びません。以前はトークン処理速度だけを追っていましたが、今回は必要なトークン数という見方を得ました。
メモリ周りでは、仮想メモリを4GBしか割り当てていませんでした。実行環境の切り替えに失敗し、2つが同時に起動してしまい、PCがハングアップする事象が発生しました。どの程度効果があるかは分かりませんが、今回の運用に合わせて、一旦32GBにしておくことにしました。
今後の方向性
実行環境の移行という目的は無事に達成できました。Qwen3.8-Flash-NextとQwen3.8-27Bの2つを、用途に応じて使い分けていく予定です。これまでローカルLLMの用途は、パソコン内のファイルやフォルダの整理や、日々のTo-Doの整理など、限られていました。コーディングエージェントでも使えるようになり、範囲が広がりました。今後は、どういった方法で使えるかを考えていきたいです。
【余談】設定値が決まるまで
ここに載せた設定値は、最初からこの形に決まっていたわけではありません。候補を一つずつ変えては計測し、速くなるものだけを残す、という確認を重ねた結果です。
Qwen3.8-Flash-Nextでは、細かな設定を単体で18件試したうえで、さらに組み合わせも確認しました。最終的に採用したのは4つです。残りは、効果が確認できなかったり、逆に遅くなったりしたため元に戻しています。1回の確認にはモデルの再起動を挟むため30〜40分程度かかり、それを何度か繰り返しました。
Qwen3.8-27Bでは、MTPのパラメータ、KVキャッシュの精度、バッチサイズの3系統で候補を試しました。MTPは複数の設定を、KVキャッシュは精度や種類を変えた場合も試しましたが、条件を変えて再確認すると改善は確認できませんでした。実際のコード編集を3ターン行う確認でも元の値を超えず、最初の値がそのまま残りました。
振り返ると、特別な一発逆転があったわけではなく、地味な計測の積み重ねでした。設定によって得られる差は限定的ですが、確かめずに決められない部分でした。
【付録】設定値など詳細
この環境で使用するために調整した値
表A モデル別の使用パラメータ
| 構成 | 設定 |
|---|---|
| Qwen3.8-Flash-Next / Strata | コンテキスト長 262K(--max-context)、KVキャッシュ int8(--kv)、KV resident 32,768(--kv-resident)、KV streaming auto(kv_streaming)、speculative decoding --spec 4 / --spec-min-p 0.7 / MTP(--mtp)、expert cache auto、prefill auto、画像入力有効(--vision、vision max_tokens 1,024)、VRAM reserve 256 MiB(--vram-reserve-mib)、PCIe fraction 0.3(--pcie-frac)、pool workers 0、STRATA_PF_FUSED=1 |
| Qwen3.8-27B / llama.cpp | コンテキスト長 131K(ctx-size)、KVキャッシュ q4_0(cache-type-k / cache-type-v)、FlashAttention on(flash-attn)、speculative decoding draft-mtp / spec-draft-n-max 2(MTPヘッド内蔵)、batch 512、ubatch 512、n-gpu-layers 99、parallel 1、n-predict 4,096、top-p 0.95、top-k 20、min-p 0、presence-penalty 0、jinja on、fit off、sleep-idle-seconds 300 |
| Qwen3.6-35B-A3B / Ollama | コンテキスト長 65K(OLLAMA_CONTEXT_LENGTH / num_ctx)、KVキャッシュ q4_0(OLLAMA_KV_CACHE_TYPE)、FlashAttention 有効(OLLAMA_FLASH_ATTENTION=1)、n-gpu-layers 99 / batch 128(num_gpu / num_batch)、speculative decoding draft_num_predict 2(MTPヘッド)、num_predict 4,096、num_keep 24、top-p 0.95、top-k 20、min-p 0、repeat_penalty 1.0、OLLAMA_NUM_PARALLEL=1、OLLAMA_MAX_LOADED_MODELS=1、OLLAMA_KEEP_ALIVE=5m、OLLAMA_GPU_OVERHEAD=0 |
テストの内容
速度テスト(3プロンプト、最大256トークン)
表B テスト内容とその目的
| 内容 | 目的 |
|---|---|
| 秋の夕暮れの情景を一文だけで書く短文生成 | 短い入力から短く生成するときの速さを見るため |
| データベース索引設計の技術メモを読み、要点3つを箇条書きでまとめる要約 | やや長い入力を読み、まとまった分量を生成するときの速さを見るため |
| 23 × 17 = 391 の正誤を計算過程と理由付きで検算する | 理由の説明を含む生成の速さを見るため |
各プロンプトの入力処理に加え、約3,000トークンの長い入力(2つ目のプロンプトを12倍したもの、実測3022〜3066トークン)を読み込む速さも測りました。送信から最終トークンまでの実時間を所要時間とします。
品質テスト(21問、最大2,048トークン)
21問を解かせ、厳密一致で正誤を判定しました。各問を2回解かせ、正答数と合計所要時間は42回分の合計、1問あたりの値は平均で報告します。内訳は、次の7種類を3問ずつ、幅を持たせて1セットにしたものです。
表C テスト種類とその内容
| 種類 | 内容 |
|---|---|
| 計算 | 複数の手順を含む計算 |
| 条件の選択と集計 | 複数条件を満たす候補の選択と条件付きの集計 |
| 順序・可能性・真偽の論理 | 順序関係、可能性、真偽の推論 |
| 短いコードの読解 | 短いコードの実行結果の追跡 |
| 文書やログからの情報抽出 | 構造化データやログからの条件付き抽出 |
| 指示の遵守 | 指定形式での回答、引用文内の命令に従わないこと |
| 整合性の判定 | 2つの資料の記載の両立と矛盾の判定 |
2026/10/05追記: Strataを0.1.39に更新した結果
記事の公開後、エンジン(Strata)の0.1.39が出ていたため0.1.38から更新し、同じモデル(Qwen3.8-Flash-Next、Swift 1.5, IQ2_XS)で本文と同じ試験をやり直しました。集計方法は本文の各表と同じです。
表D Strataの更新前後での比較
| 指標(単位) | 0.1.38 | 0.1.39 | 差 |
|---|---|---|---|
| トークン処理速度(トークン/秒) | 89.31 | 105.17 | +17.8% |
| 1リクエストあたりの所要時間(秒) | 2.52 | 2.44 | -2.9% |
| 1リクエストあたりの出力トークン数(個) | 167.5 | 183 | +9.3% |
| 長い入力の読み込み速度(トークン/秒) | 2202.40 | 2218.90 | +0.7% |
| 正答数(/42問) | 41 | 41 | 同じ |
0.1.38の値は本文の掲載値、0.1.39は再測定です。品質は変わらず、トークン処理速度は約18%上がりました。所要時間の短縮が小さいのは、1回あたりの出力トークン数が増えたためです。値は目安として見てください。
今回の更新にあわせて、自分の設定値として vram_elastic(必要になったときだけVRAMを解放する機能。呼び出さなければ従来どおり)を追加しました。
更新を見越して作った自作スクリプトも不具合がありましたが、直して使える状態になるのを確認できたのは収穫でした。
0.0.1の更新でも結果が変わったので、折に触れて本家の動向を確認しておくとよいと感じました。